Ingestão de Dados: O que é, como funciona e por que se tornou essencial na era da informação
Entenda o que é ingestão de dados, como funciona, seus modelos, ferramentas e boas práticas essenciais para pipelines modernos e escaláveis.
Neste artigo
Em um mundo cada vez mais orientado por dados, empresas de todos os tamanhos enfrentam o mesmo desafio: como reunir informações provenientes de múltiplas fontes, em formatos diferentes e em velocidades distintas. É exatamente aqui que surge um dos processos mais importantes da engenharia de dados moderna: a ingestão de dados.
Se você atua com desenvolvimento, arquitetura, analytics, cloud ou soluções corporativas, dominar esse conceito é fundamental para construir pipelines robustos, escaláveis e confiáveis. Neste artigo, vamos explorar em profundidade o que é ingestão de dados, como funciona, seus modelos, ferramentas e boas práticas.
🚀 O que é ingestão de dados?
Ingestão de dados é o processo responsável por coletar, importar e mover dados de diversas fontes para uma plataforma centralizada, onde eles poderão ser armazenados, processados e analisados.
Em outras palavras, é a “porta de entrada” do ecossistema de dados.
Sem uma boa estratégia de ingestão, não há data lake, data warehouse, dashboards, modelos de IA ou análises avançadas que funcionem corretamente.
🧩 Por que a ingestão se tornou tão importante?
Hoje, os dados estão espalhados por dezenas de lugares:
- Bancos de dados relacionais
- Sistemas internos de ERP e CRM
- APIs externas
- Ferramentas de marketing
- Aplicações web e mobile
- Logs de servidores
- Sensores IoT
- Marketplaces, gateways de pagamento e muito mais
Cada sistema fala um idioma diferente.
Cada origem tem um padrão próprio.
A ingestão de dados unifica tudo isso e permite que a empresa tenha:
- Dados confiáveis
- Atualizações constantes
- Histórico para análises avançadas
- Base sólida para tomada de decisão
- Automação de processos
- Observabilidade sobre o negócio
Sem ingestão, você tem dados isolados, processos manuais, análises lentas e alto risco de erro humano.
🏗️ Como funciona o processo de ingestão?
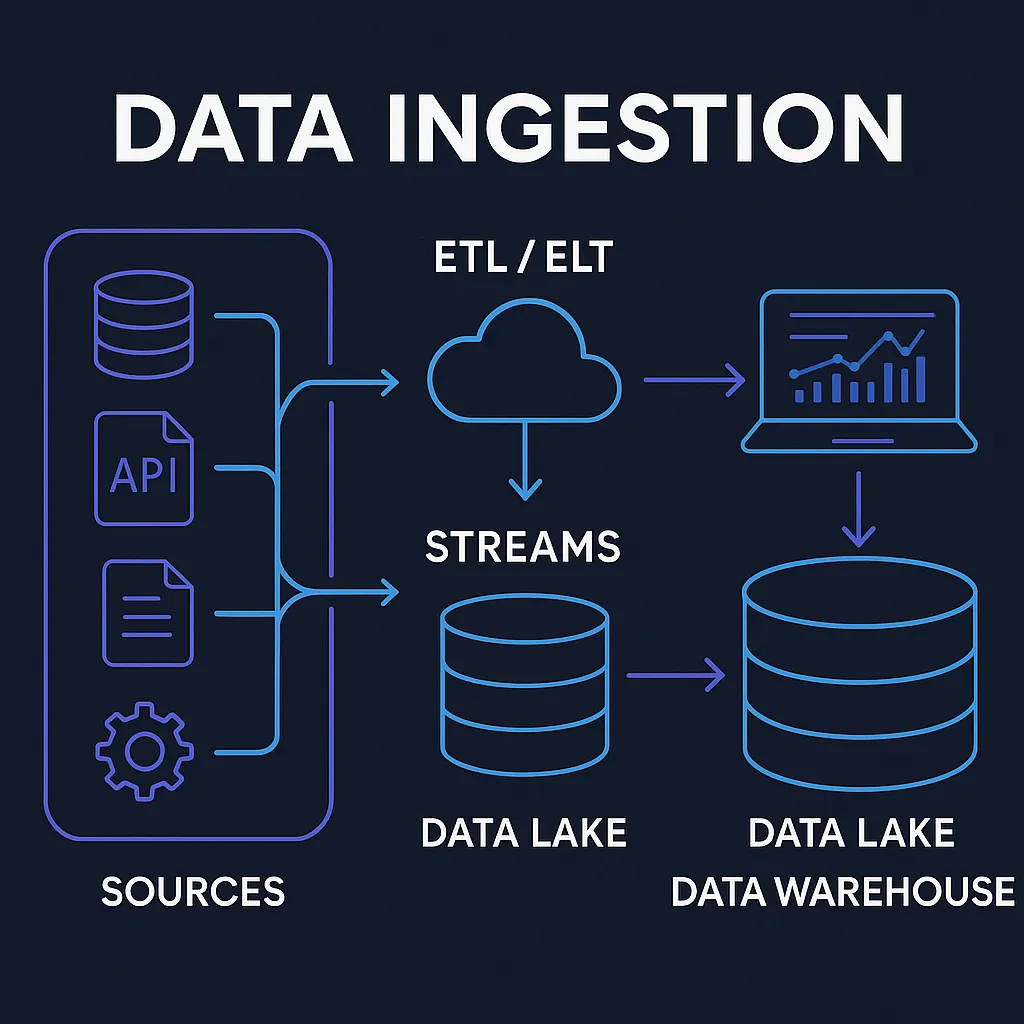
Geralmente, ele é dividido em 3 grandes etapas:
1. Coleta
É o momento em que o pipeline busca dados nas fontes de origem.
Tais fontes podem ser:
- Bancos SQL e NoSQL
- APIs REST
- Streams de eventos
- Arquivos CSV, Excel, JSON
- Filas de mensagens
- Logs de aplicações
- Sistemas de terceiros (Facebook Ads, Google Ads etc.)
O grande desafio aqui é lidar com:
- Diferentes formatos
- Conectores heterogêneos
- Frequências variadas
- Erros de rede
- Atualizações de esquema (schema evolution)
2. Transporte
Depois de coletados, os dados precisam ser movimentados até o destino. Isso pode ser feito por:
- ETL tradicional (extrai → transforma → carrega)
- ELT moderno (extrai → carrega → transforma no destino)
- Streaming (dados em tempo real)
- Batch (execuções periódicas)
Ferramentas modernas incluem:
- Apache Kafka
- AWS Kinesis
- Airflow
- Fivetran
- dbt
- Glue
- Databricks
- NiFi
O objetivo é entregar dados com segurança, consistência e mínimo tempo de latência.
3. Armazenamento
Após o transporte, eles finalmente chegam ao destino:
- Data Lake (S3, GCP Storage, Azure Blob)
- Data Warehouse (BigQuery, Redshift, Snowflake)
- Lakehouse (Databricks Delta Lake)
- Bancos analíticos OLAP (ClickHouse, Druid)
Aqui, os dados podem seguir para:
- Modelagem
- Enriquecimento
- Machine learning
- BI
- Dashboards
- Aplicações downstream
🔁 Modelos de ingestão: Batch vs. Streaming
A forma como você ingere os dados afeta diretamente os resultados.
⏳ Ingestão Batch (Em Lotes)
Os dados são coletados e processados em intervalos, como:
- A cada hora
- 1x por dia
- Todo início de mês
- Em janelas configuráveis
Indicado para:
- Relatórios gerenciais
- Dados que não mudam constantemente
- Custos mais baixos de processamento
⚡ Ingestão Streaming (Em Tempo Real)
Os dados são coletados continuamente, assim que acontecem.
Indicado para:
- Monitoramento de eventos
- Sistemas antifraude
- Telemetria de sistemas
- Aplicações inteligentes
- Dashboards em tempo real
Ferramentas como Kafka e Spark Streaming são comuns nesse contexto.
🧠 Arquitetura moderna de ingestão de dados
Uma arquitetura madura costuma incluir:
- Orquestração (Airflow, Dagster)
- Conectores prontos (Fivetran, Meltano)
- Mensageria (Kafka)
- Processamento distribuído (Spark, Flink)
- Data Lake + Warehouse (Lakehouse)
- Catálogo de dados
- Governança e qualidade (DQ)
- Monitoramento de pipelines
Empresas que escalam bem suas estratégias de dados geralmente usam o modelo ELT e arquiteturas baseadas em lakehouse.
🧭 Boas práticas para ingestão de dados
Para uma ingestão sólida, é recomendável seguir princípios como:
1. Esquemas bem definidos (schema registry)
Permite evolução sem quebrar pipelines.
2. Logs detalhados e observabilidade
Ajuda a detectar falhas rapidamente.
3. Processamento idempotente
Para que o sistema tolera reprocessamentos sem duplicar dados.
4. Segurança e compliance
Criptografia, mascaramento e controle de acesso.
5. Modularidade e acoplamento mínimo
Facilita manutenção.
6. Alta disponibilidade e resiliência
Pipelines precisam ser à prova de quedas.
🎯 Conclusão
A ingestão de dados é o primeiro — e talvez o mais importante — passo de toda jornada de dados. Sem uma estratégia clara, os dados permanecem dispersos, inconsistentes e inutilizáveis.
Com uma ingestão bem planejada, sua empresa ganha:
- Escalabilidade
- Precisão analítica
- Velocidade de decisão
- Eficiência operacional
- Fundamento sólido para IA e automação
Na era digital atual, quem domina o fluxo de dados, domina o futuro.
